
发出去的稿子被删了,大模型还能记住吗?答案可能和你想的不一样
做品牌传播、GEO 优化的从业者,大多都有过这样的焦虑:耗费大量精力撰写的稿件、落地的人物专访、对外发布的新闻稿,时隔一段时间再打开链接,页面已经 404。
页面失效的瞬间,很多人第一时间就会产生疑问:大模型还能不能抓取这篇内容?前期投入的传播与优化成本,是不是就此付诸东流?
结论或许和很多人的直觉相悖:依然可以被引用,且内容在 AI 体系内的存活周期,远比想象中更长。
一份覆盖 1.29 亿次 AI 引用的追踪研究,揭示了一个反常识的现象:网页原文删除 8 个月之后,对应的 AI 引用量依旧没有归零。
更值得留意的是,页面删除后的首月,引用数据甚至出现抬升,峰值可达原有基准值的 128%,之后才进入缓慢下行通道,但始终无法清零。
也就是说,我们以为删除链接就能抹除内容,实际上大模型仍会持续调用这份已经失效页面里的信息,并且在删稿初期,引用频次反而更高。背后的核心原因,是大模型获取信息存在两条相互独立的路径,网页删除操作,对二者的影响截然不同。
路径一:训练权重里,近乎永久的模型记忆
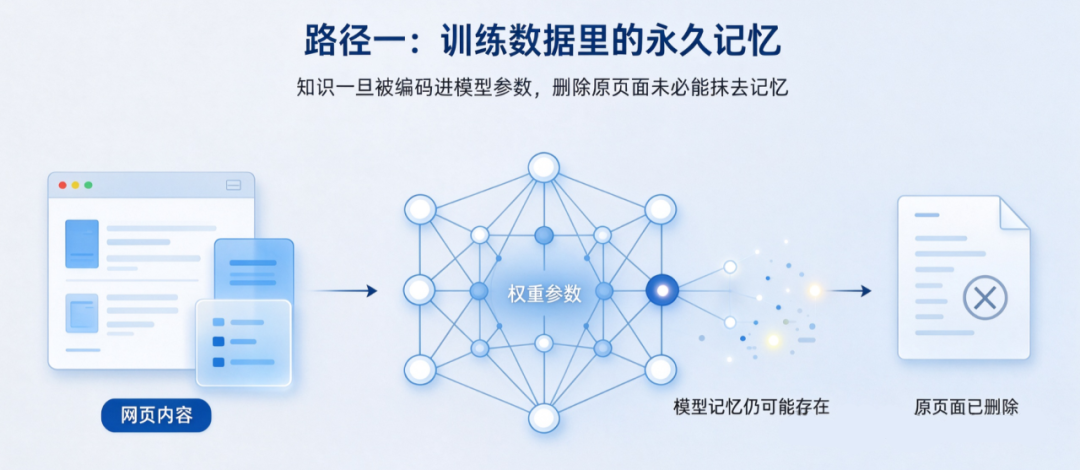
第一条路径,来自模型的训练数据集。 简单来讲,大模型在预训练阶段会批量收录海量网页文本,将信息编码固化到模型权重参数之中。训练完成之后,相关知识就沉淀在模型内部,如同人读完书籍形成记忆,即便书本损毁,记忆依旧留存。
只要这篇稿件曾经参与模型训练,哪怕源站页面删除,模型依旧保有相关信息。除非厂商启动新一轮全量训练,或是针对性执行机器遗忘操作,否则存储在参数内的记忆会长期留存。
这也解释了为什么不少品牌试图通过删稿清除负面信息、抹除历史痕迹,效果往往不达预期:根植于训练数据里的记忆,单靠下架网页链接无法消除。
路径二:RAG 检索链路,多层缓存延长内容生命周期
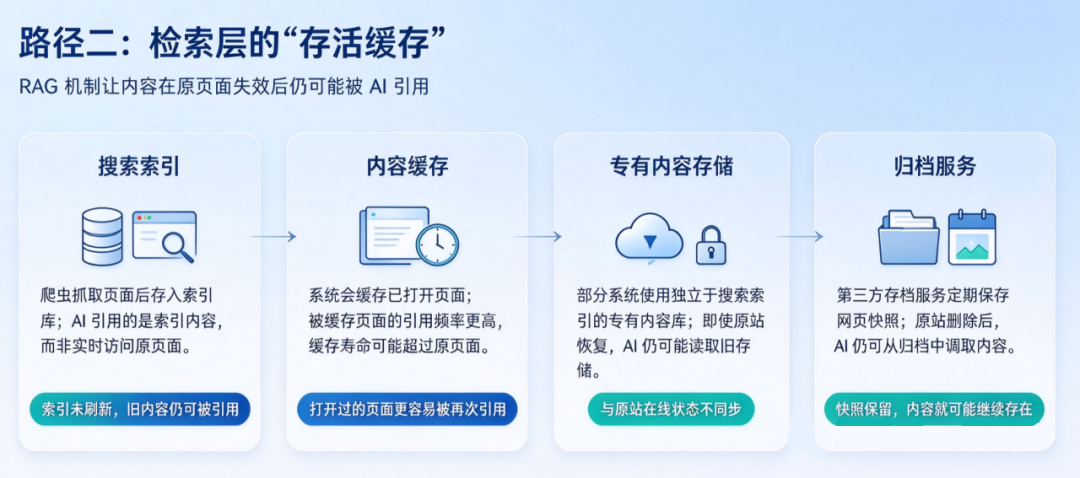
第二条路径,是当下 AI 搜索普遍采用的 RAG 检索增强生成架构。这条链路环节复杂,内容留存的载体也更多元。
首先是搜索引擎索引。爬虫抓取页面后,会将文本存入索引库。AI 生成回答调取内容时,读取的是索引快照,并非实时访问源页面。索引未更新前,即便原链接 404,AI 依旧可以正常引用文本。
其次是平台私有缓存。类似 ChatGPT 这类产品,会留存访问过的页面缓存。有缓存记录的内容,被引用概率远高于仅进入公共索引的页面,缓存的存续周期,经常超过源页面本身。
再者是独立专有内容库。部分 AI 系统不依赖实时网页检索,配套搭建独立的内容存储池。研究中曾观测到特殊案例:源站页面已经恢复上线,AI 输出却依旧标注 404,根源就是 AI 读取的是自有存储版本,和官网页面状态不同步。
最后是第三方归档快照。互联网档案馆 Wayback Machine、Common Crawl 等全网归档服务,会持续抓取并留存网页快照。源站删除原文,归档库中仍有备份,AI 可直接从归档快照调取素材。
不同 AI 平台,遗忘速度差异显著
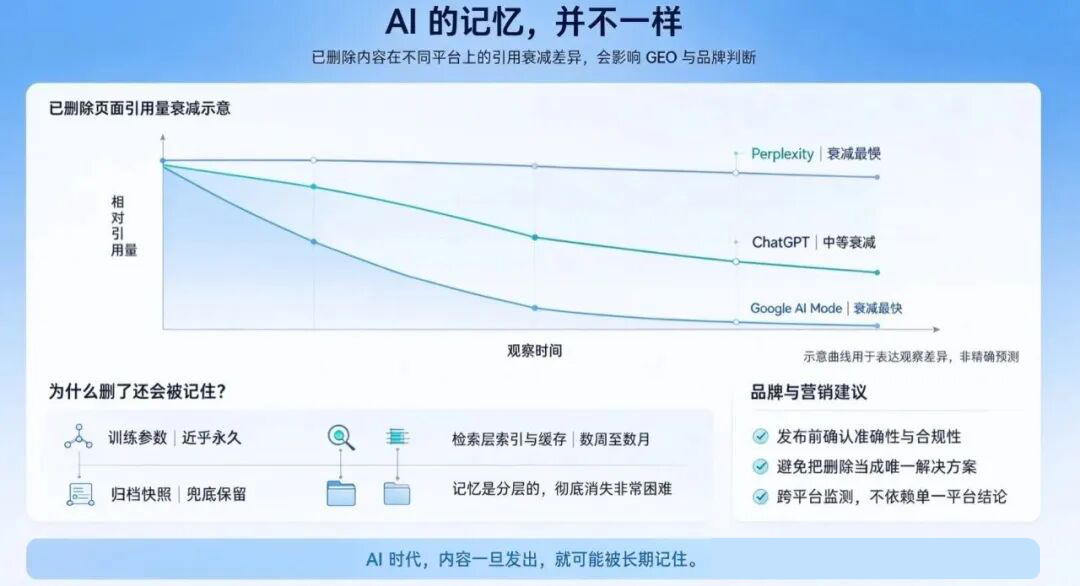
各大 AI 产品对失效内容的保留策略并不统一,记忆衰减节奏差别巨大。 研究以阿里巴巴 Product Insights 页面下架后的引用变化作为观测样本:
- Google AI Mode 衰减速度最快,一周内引用量腰斩,长期来看基本归零
- ChatGPT 衰减节奏中等,约 13 周后引用量减半
- Perplexity 遗忘最慢,在整个观测周期内引用量未出现腰斩,持续高频引用已删除页面
这意味着做 GEO 效果监测时,如果仅选取单一平台的数据作为判断依据,结论很容易出现较大偏差。
总结来看,大模型对已删内容的记忆分为三层:
- 模型训练参数内的记忆:近乎永久
- 检索索引、平台缓存:可维持数周至数月
- 第三方归档快照:作为长期兜底存储
想要让一段已经对外发布的内容在 AI 体系内彻底消失,技术门槛极高,落地难度很大。
对于品牌传播与 GEO 优化从业者而言,与其事后耗费精力尝试删稿清痕迹,不如前置把控内容质量。在稿件发布前反复校验,保证信息准确、表述合规、经得起长期检索与传播。

